Redacta desde cuatro idiomas
Escribe reglas en inglés, francés, alemán o español, en modo Decisión o Argumento. La ambigüedad vuelve como opciones concretas: para «A o B y C» ves (A OR B) AND C, A OR (B AND C) y un caso en el que difieren.
Funciones
Redacta con palabras, fórmulas o diagramas, sobre entradas booleanas, números, categorías, escalas, conteos y puntuaciones. Comprueba cada caso de forma exacta. Explícala en lenguaje claro, pruébala como si fuera código, conserva todo su historial y expórtala a las herramientas que tu equipo ya usa.
Redactar
Cada vista edita el mismo modelo tipado, así que el texto original en lenguaje claro, la fórmula y el diagrama de compuertas nunca pueden separarse sin que lo notes. Mueve una compuerta y solo cambia la disposición; renombra una entrada y todas las referencias la siguen.
¿Empiezas desde las palabras? Describe la regla y la IA redacta una fórmula, un glosario y las preguntas que no pudo resolver. El borrador se mantiene sin confirmar hasta que digas que significa lo que querías decir.
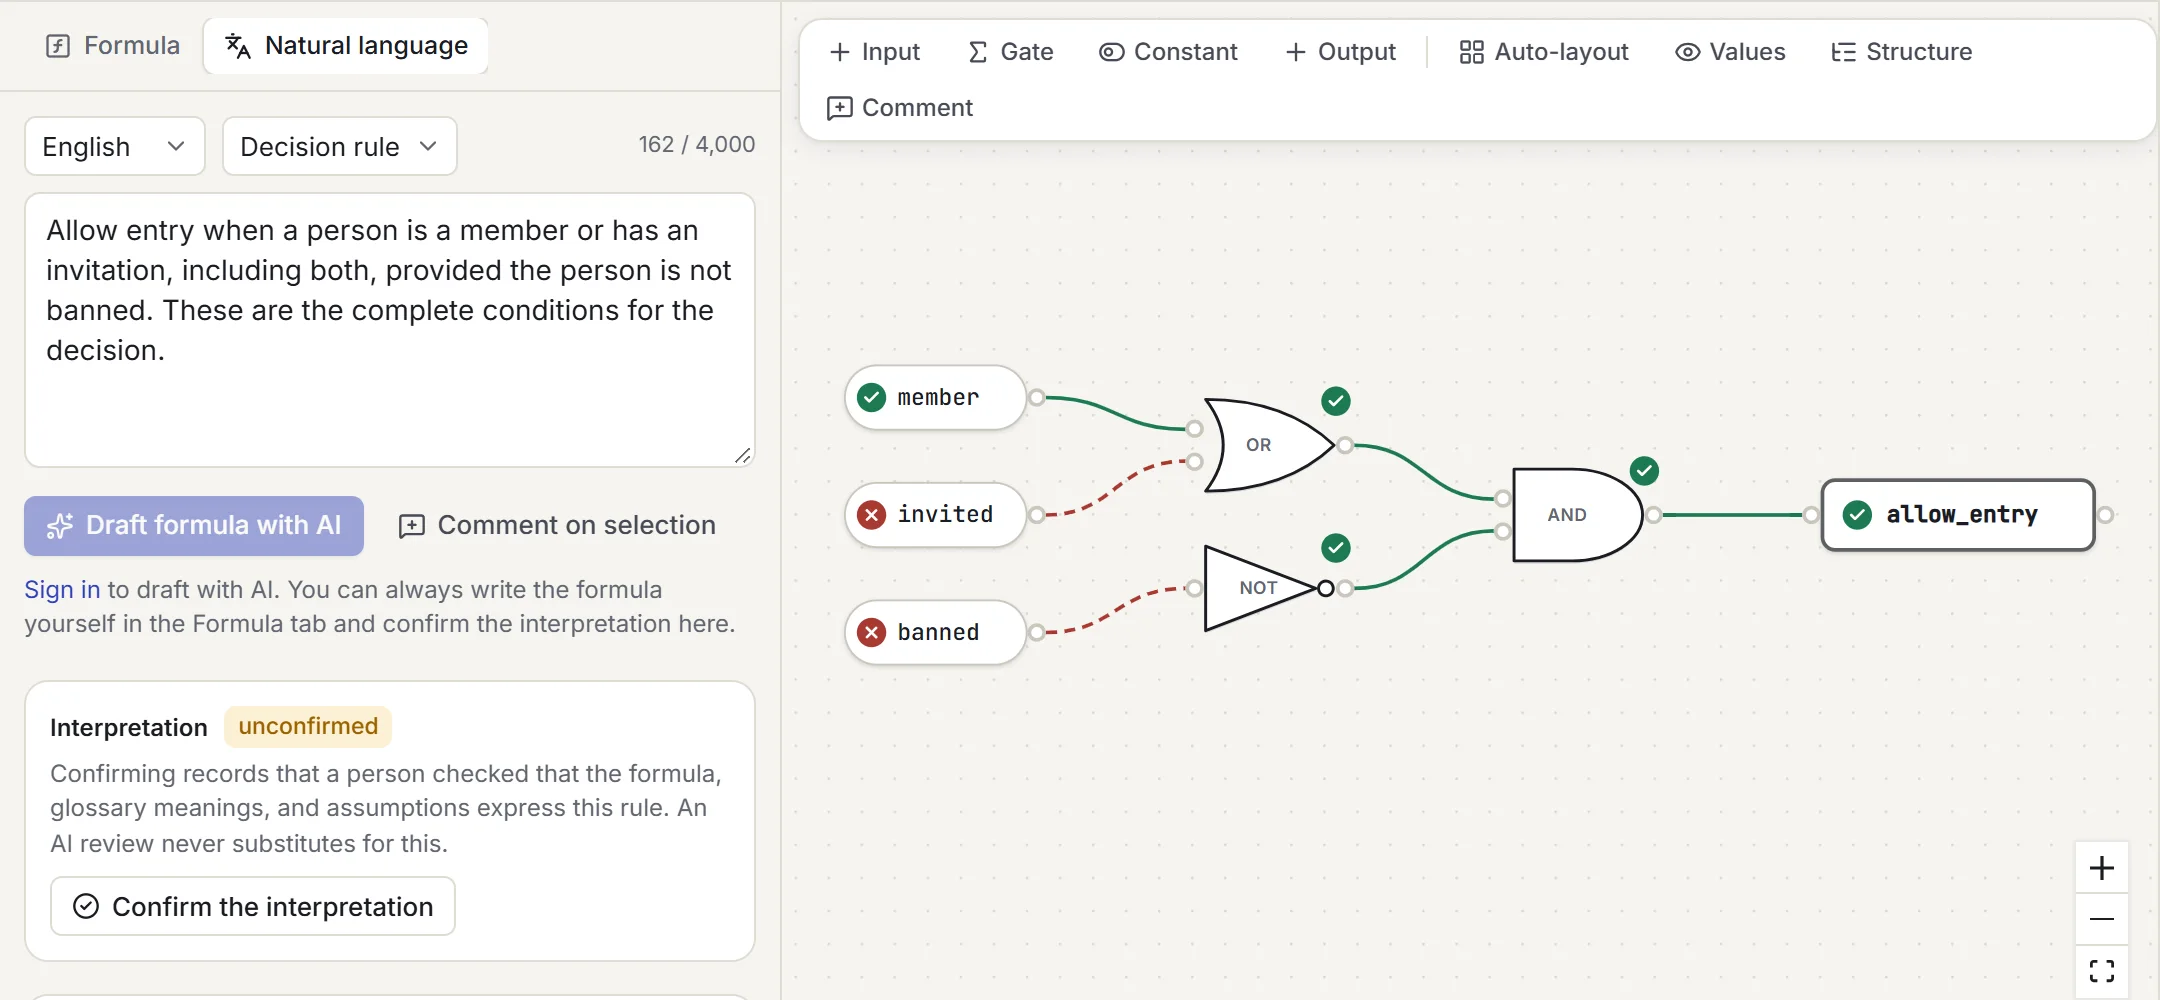
Escribe reglas en inglés, francés, alemán o español, en modo Decisión o Argumento. La ambigüedad vuelve como opciones concretas: para «A o B y C» ves (A OR B) AND C, A OR (B AND C) y un caso en el que difieren.
De programación (AND, &&, !), matemática (∧ ∨ ¬ → ↔) o de libro de texto (A·B, A+B, barras superiores, mintérminos indexados). Todas compilan al mismo modelo, y AB es siempre un solo nombre, nunca un AND oculto.
Entradas, constantes y todas las compuertas admitidas, con puertos etiquetados, zoom, desplazamiento y disposición automática. Al lado hay una vista de estructura manejable con el teclado, así que nada depende de arrastrar.
Da a cada entrada un significado humano y enuncia las restricciones de forma explícita. Tangibool nunca asume que «socio premium» implica «socio» a menos que tú mismo añadas ese supuesto.
Guarda una selección como un subcircuito con nombre, versión y puertos tipados. Cada instancia queda fijada a una versión y nunca se actualiza en silencio; expándela para ver los valores de dentro. Mantén bibliotecas para ti o para tu equipo.
Deshacer y rehacer en todas partes. Un borrador inválido nunca sobrescribe tu último modelo válido: este sigue visible, claramente etiquetado como la revisión válida anterior, hasta que corrijas los errores de tu texto actual.
Las reglas dependen de edades, importes, planes, países, calificaciones, conteos y puntuaciones. Define cada uno fuera de la fórmula y Tangibool lo compila a entradas VERDADERO/FALSO con los hechos entre ellas derivados de forma exacta y etiquetados como derivados, así que cada comprobación sigue siendo de dos valores y cada resultado sigue siendo exacto.
«La edad es al menos 18» se convierte en la entrada de umbral age_at_least_18, definida como age ≥ 18 sobre una cantidad de números enteros o decimales. Escribe una comparación en una fórmula y el editor te ofrece la definición. Da un número en un escenario y cada umbral sobre esa cantidad se decide por comparación exacta, con el orden entre umbrales derivado por ti: quien tiene 25 años o más tiene 21 o más.
Define plan con Free, Basic, Pro y Team, o country con códigos ISO, y nombra listas de valores: EEE, planes de pago, o la unión, intersección o diferencia de otras listas. Una entrada de categoría toma un valor, una entrada de conjunto toma cualquier subconjunto, y las fórmulas comprueban la pertenencia con plan IN Paid o activities HAS NONE Excluded. Hechos como «todo plan colaborativo es de pago» se derivan de las listas, nunca se suponen.
Calificaciones crediticias, clases de riesgo, niveles de cliente: una escala enumera sus niveles de menor a mayor, más valores externos como «Sin calificar» que no satisfacen ninguna comparación. rating ≥ BBB- recibe límites en los niveles vecinos y pruebas de límite, una entrada de comparación relaciona dos cantidades en una misma escala, y una correspondencia entre dos escalas debe conservar el orden y es un recurso versionado que tú confirmas.
«Al menos dos de tres criterios» es un conteo, no una cadena de XOR. AT_LEAST(k; …), AT_MOST(k; …) y EXACTLY(k; …) toman dos o más condiciones y aparecen como una sola compuerta en el diagrama, con la lectura literal «al menos 2 de …» y casos límite con k−1, k y k+1 condiciones.
Una puntuación suma los puntos de las filas cuya condición se cumple, y los umbrales de puntuación como score_at_least_5 son entradas que tus fórmulas usan por su nombre. El rastreo de evaluación enumera la contribución de cada fila y el total, el rango de la puntuación se muestra, y un corte fuera de ese rango se señala como constante.
Una decisión puede tener más de dos resultados: Aprobar, Derivar, Rechazar. Defínelos como una condición por resultado, como una lista de reglas en la que gana la primera que coincide, o como una tabla de decisión con la política de coincidencia Única, Cualquiera, Primera o Prioridad. Las fórmulas leen un resultado como una categoría: preapproval IN {Approve, Refer}.
Comprobar
Haz una pregunta precisa y obtén una respuesta precisa: se cumple o no, con la asignación que lo demuestra. Cada resultado indica la propiedad comprobada, los supuestos, el método y la revisión a la que se aplica.
¿Puede ser verdadero? ¿Es siempre verdadero? ¿Puede llegar a ser falso? ¿Son equivalentes estas dos? ¿Se sigue la conclusión? ¿Es esta regla al menos tan estricta como aquella? ¿Recibe cada caso exactamente un resultado? Cada una es una consulta de satisfacibilidad precisa, no una suposición.
Cada contraejemplo y cada testigo se vuelve a ejecutar en el evaluador antes de mostrarse. Cárgalo en la simulación o guárdalo como prueba de regresión con un clic.
La consistencia de los supuestos se comprueba antes que nada. Un conjunto de supuestos imposible nunca puede producir una etiqueta de «todas las pruebas pasan» ni de «equivalente».
Enuncia premisas y una conclusión. Obtén «válido», o la asignación en la que todas las premisas se cumplen y la conclusión falla. Las premisas que se contradicen entre sí reciben una advertencia destacada, no un éxito hueco.
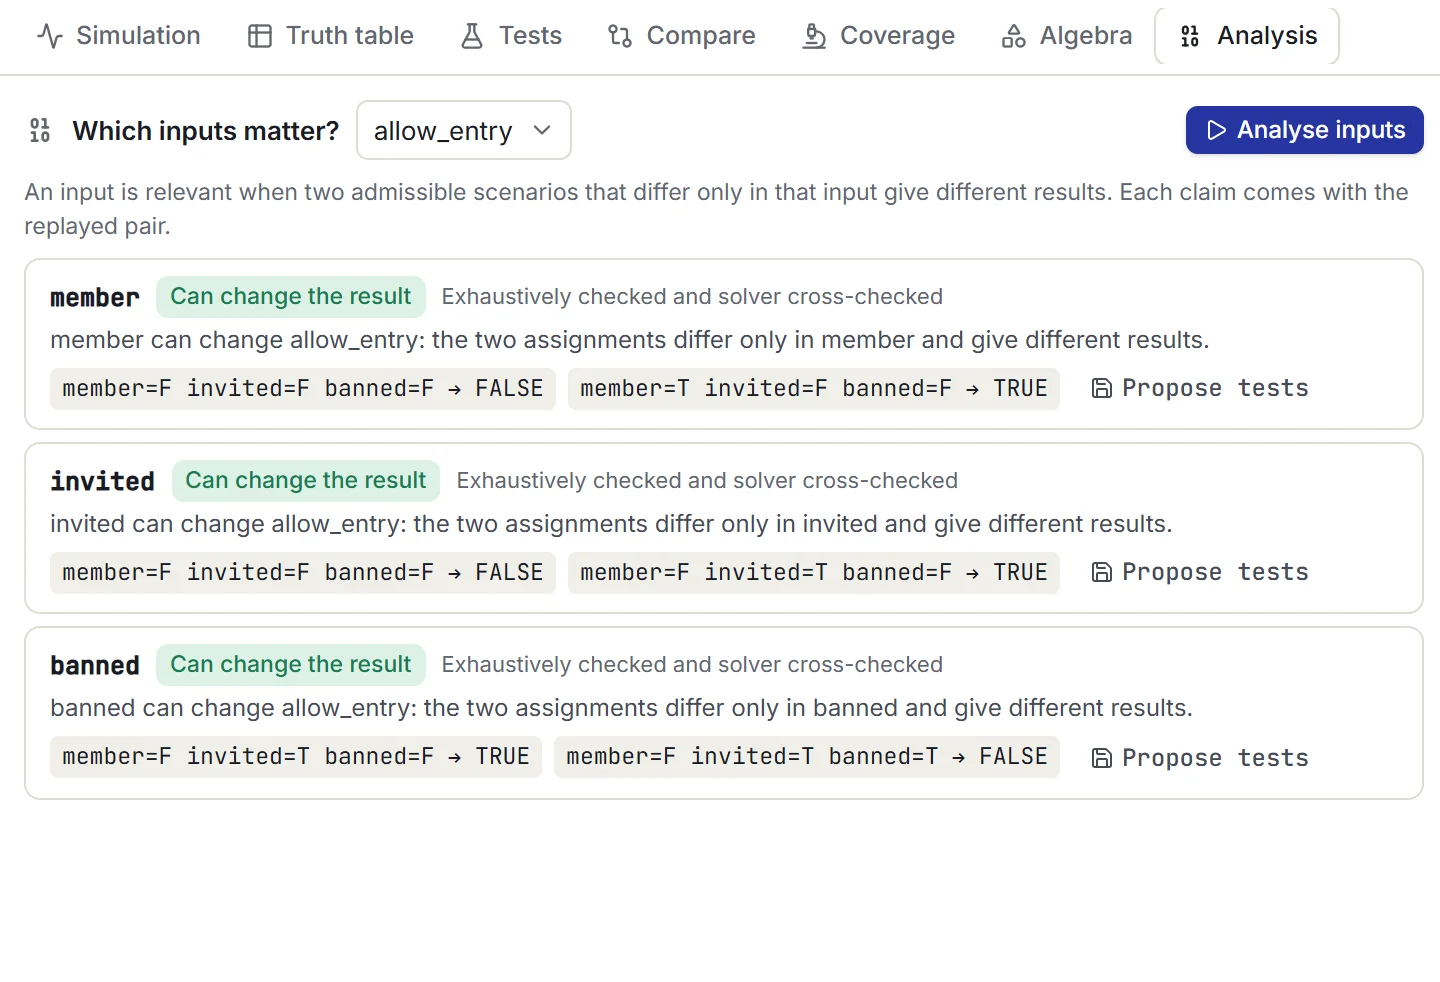
Comprueba si cada entrada puede cambiar un resultado, demostrado con dos asignaciones que difieren solo en esa entrada. Averigua si una premisa ya se sigue de las demás.
Cuando los supuestos o las premisas no pueden cumplirse todos a la vez, Tangibool devuelve un subconjunto en conflicto, comprobado y vinculado a tus cláusulas originales, y dice con claridad qué no se probó.
Para una salida o un resultado, mira las condiciones necesarias que comparten todos los casos que cumplen, las formas de cumplir, cada una un conjunto de hechos que garantiza el resultado y del que no sobra ninguno, primero las de menos hechos, una razón irreducible para un caso, y los cambios mínimos en las entradas que permites cambiar que dan un resultado distinto. Cada hecho se reproduce, y una lista solo se llama completa cuando el motor ha comprobado que lo es.
Compara dos reglas, dos revisiones o dos ramas: al menos tan estricta, equivalente, menos estricta o incomparables, con un caso reproducido por cada dirección que falla. Dibuja un mapa de rigor para hasta doce reglas, declara capas de reglas como regulación, folleto, mandato y límite interno y comprueba cada una contra la que tiene encima, y enuncia que subir una entrada nunca convierte un resultado de VERDADERO en FALSO. Cada respuesta es exacta, y cada una se ejecuta como prueba de propiedad.
Un conjunto de resultados se comprueba en completitud y exclusividad: cada caso admisible recibe un resultado, y ningún caso recibe dos. Las lagunas, las superposiciones y las filas que nunca pueden aplicarse se informan con casos reproducidos y nunca se reparan a tus espaldas, y una tabla con una laguna o una superposición se exporta solo como borrador etiquetado.
Los modelos pequeños se comprueban sobre todas las asignaciones en tu navegador y se contrastan con un solucionador SAT. Los más grandes usan una consulta acotada al solucionador en el servidor, con un presupuesto por defecto de dos segundos, y solo después de que aceptes enviar el modelo. Los análisis que necesitan muchas consultas, como las formas de cumplir o un mapa de rigor, comparten un presupuesto de diez segundos y se etiquetan como parciales cuando se agota.
Explicar
Cada fórmula recibe una lectura literal generada por el motor, no por la IA, así que es exactamente tan precisa como la lógica. Cambia de escenario y un rastreo de evaluación explica por qué cada compuerta vale VERDADERO o FALSO.
allow_entry es verdadero exactamente cuando se cumplen las dos condiciones siguientes:
member («la persona es socia») o invited («la persona tiene invitación») es verdadero (pueden serlo ambos)banned («la persona está vetada») es falsoEn cualquier otro caso, allow_entry es falso.
Por qué · rastreo de evaluación
Probar
Simula escenarios, mira la tabla de verdad completa, guarda pruebas con su procedencia y averigua hasta qué punto son buenas esas pruebas. Después ejecuta el mismo conjunto en integración continua.
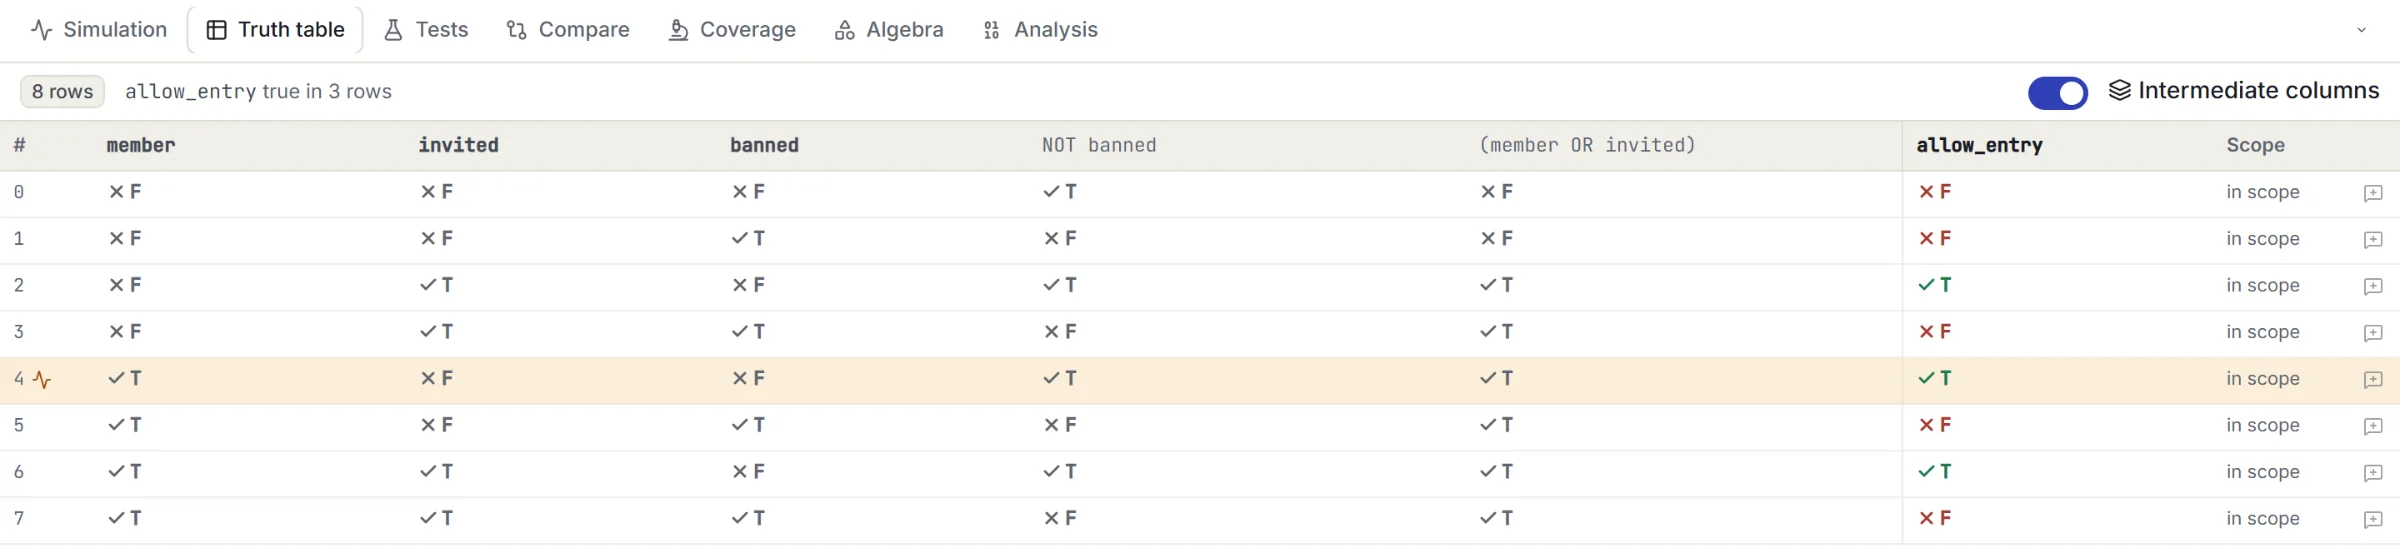
Alterna las entradas y mira cómo fluyen los valores por el diagrama. Da un número, un nivel, un valor o un conjunto y cada prueba sobre esa cantidad se decide por comparación exacta. Una entrada que no has fijado no tiene valor y nunca se trata en silencio como FALSO.
Guarda pruebas de escenario y de propiedad con notas. Un escenario puede esperar una etiqueta de resultado, y una etiqueta distinta falla nombrando la fila o la condición que decidió. Cada expectativa registra de dónde salió: Independiente cuando la confirmó una persona, Exploratoria cuando se copió de la propia fórmula.
Vuelve a ejecutar después de cada edición. Los resultados de revisiones anteriores se marcan como obsoletos, las pruebas que empiezan a fallar se destacan, y la ruta que falla se traza en el diagrama.
Cobertura de valores de entrada, de salidas de compuertas y de resultados de decisión, y además de clases de categoría, límites de conteo, etiquetas de resultado y filas de tablas de decisión, más la influencia de cada entrada mostrada con pares de escenarios. Cada métrica publica su denominador, y las clases y las filas inalcanzables se excluyen y se enumeran.
Hasta 500 mutantes de una sola edición, generados con semilla: intercambios AND↔OR, negaciones, sustituciones y cláusulas eliminadas, y para las entradas más ricas un umbral o un corte desplazado, un conteo cambiado, un miembro movido de una lista, un peso cambiado, o una fila eliminada o reordenada. Los mutantes equivalentes se detectan por comparación exacta, y la puntuación nunca oculta lo que excluyó.
El comando tangibool ejecuta el mismo motor sobre paquetes exportados, con informes JSON y JUnit. Código de salida 0 solo cuando se ejecutó al menos una prueba aplicable y todas pasaron.
Tangibool propone pruebas de límite a cada lado de un umbral o de un corte de puntuación, y pruebas por clase, un escenario por cada clase de valores de categoría que la lógica trata igual. La cobertura informa de si cada conteo se observó con k−1, k y k+1 condiciones. Cada propuesta es exploratoria hasta que la confirmas.
«Al menos tan estricta como» y «subir esta entrada nunca convierte el resultado de VERDADERO en FALSO» se guardan como pruebas de propiedad con los estados aprobada, fallida, vacua y no determinada. Se ejecutan en los conjuntos de pruebas, en el navegador y en el ejecutor sin interfaz.
Una prueba guardada conserva el número, el nivel, el valor o el conjunto que diste, así que editar una lista o un umbral cambia lo que la prueba comprueba, marca como obsoletos los resultados anteriores y aparece en la comparación de comportamiento con un testigo que da un valor.
Las pruebas de mutación introducen pequeños errores deliberados en tu regla y comprueban si tus pruebas guardadas lo notan. Un mutante superviviente viene con el escenario que lo distingue, listo para convertirse en tu siguiente prueba.
La puntuación es muertos ÷ (muertos + supervivientes). Los mutantes equivalentes, inválidos, fuera de alcance y no determinados se muestran por separado, y un denominador vacío nunca se informa como 100%.
tangibool test project.json --revision main \
  --junit reports/tangibool.xml --json reports/tangibool.json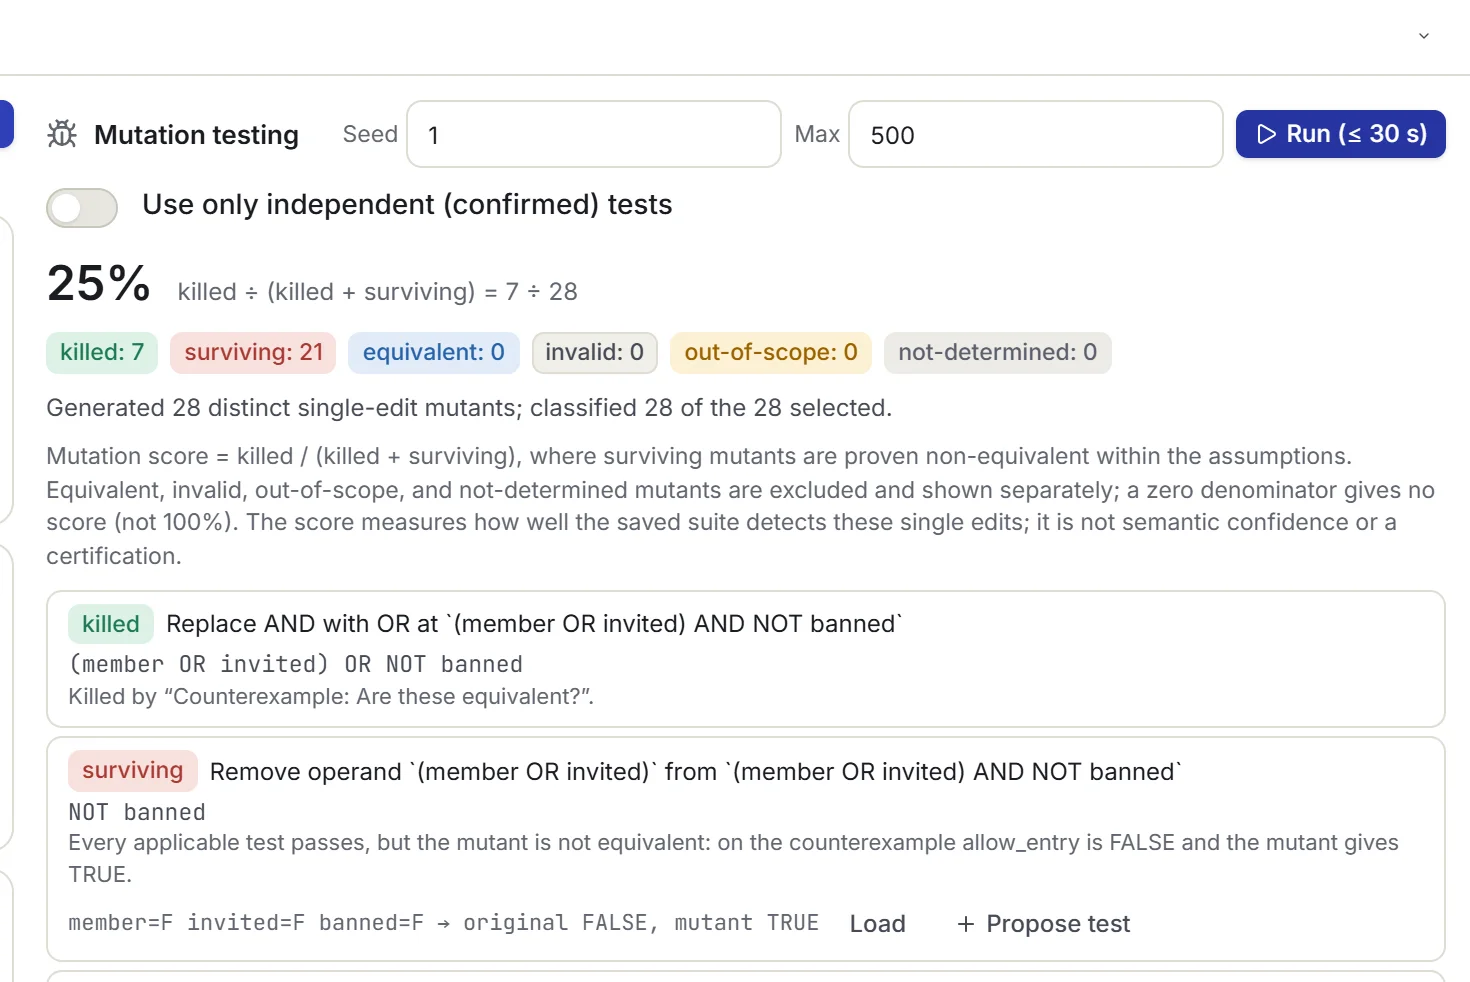
Álgebra
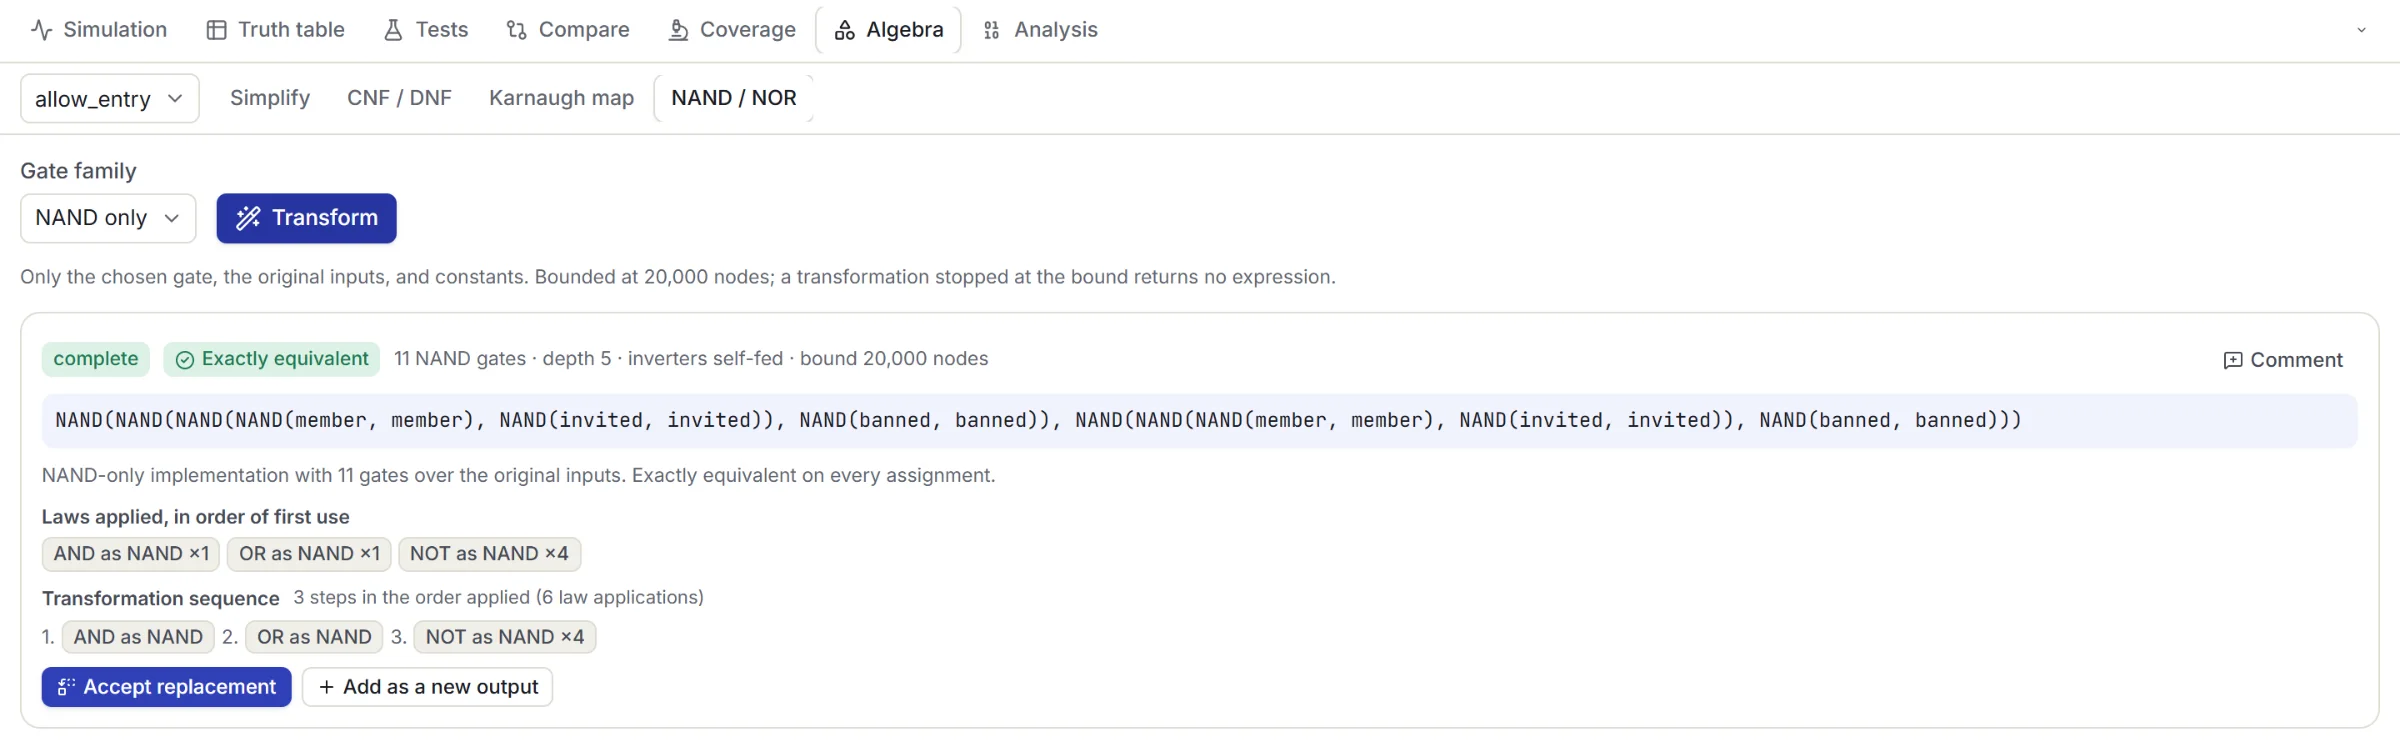
Cada transformación muestra su alcance, su tamaño y un resultado de equivalencia exacto antes de que la aceptes. Tu original sigue siendo editable hasta que elijas el reemplazo.
count-expansion, dentro de los mismos límites. Los umbrales de puntuación siguen siendo referencias y solo se expanden bajo demanda.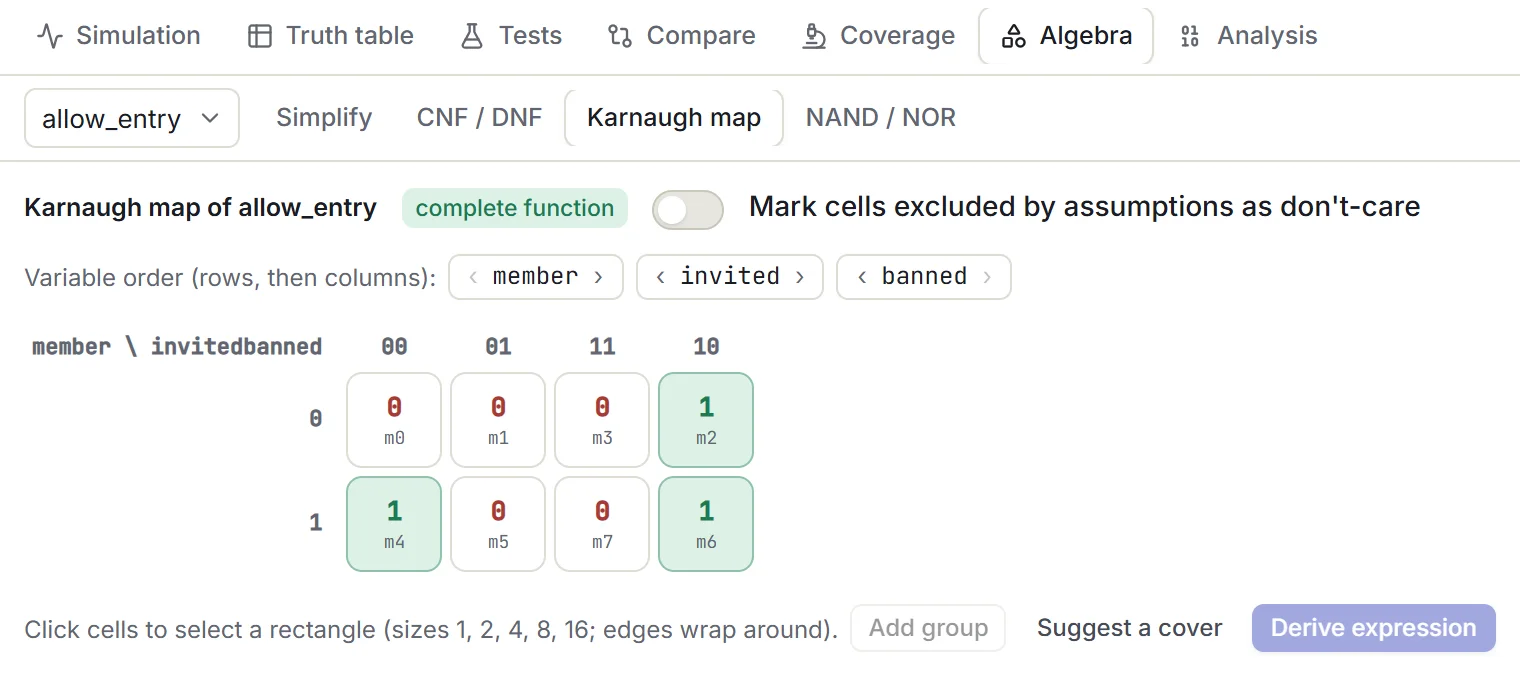
Historial
No es una capa sobre Git: es un historial nativo que entiende las reglas. Un commit captura juntos la lógica, la redacción, el glosario, el diagrama, los supuestos, las pruebas y las notas compartidas, así que una fórmula antigua nunca puede emparejarse con un diagrama más nuevo.
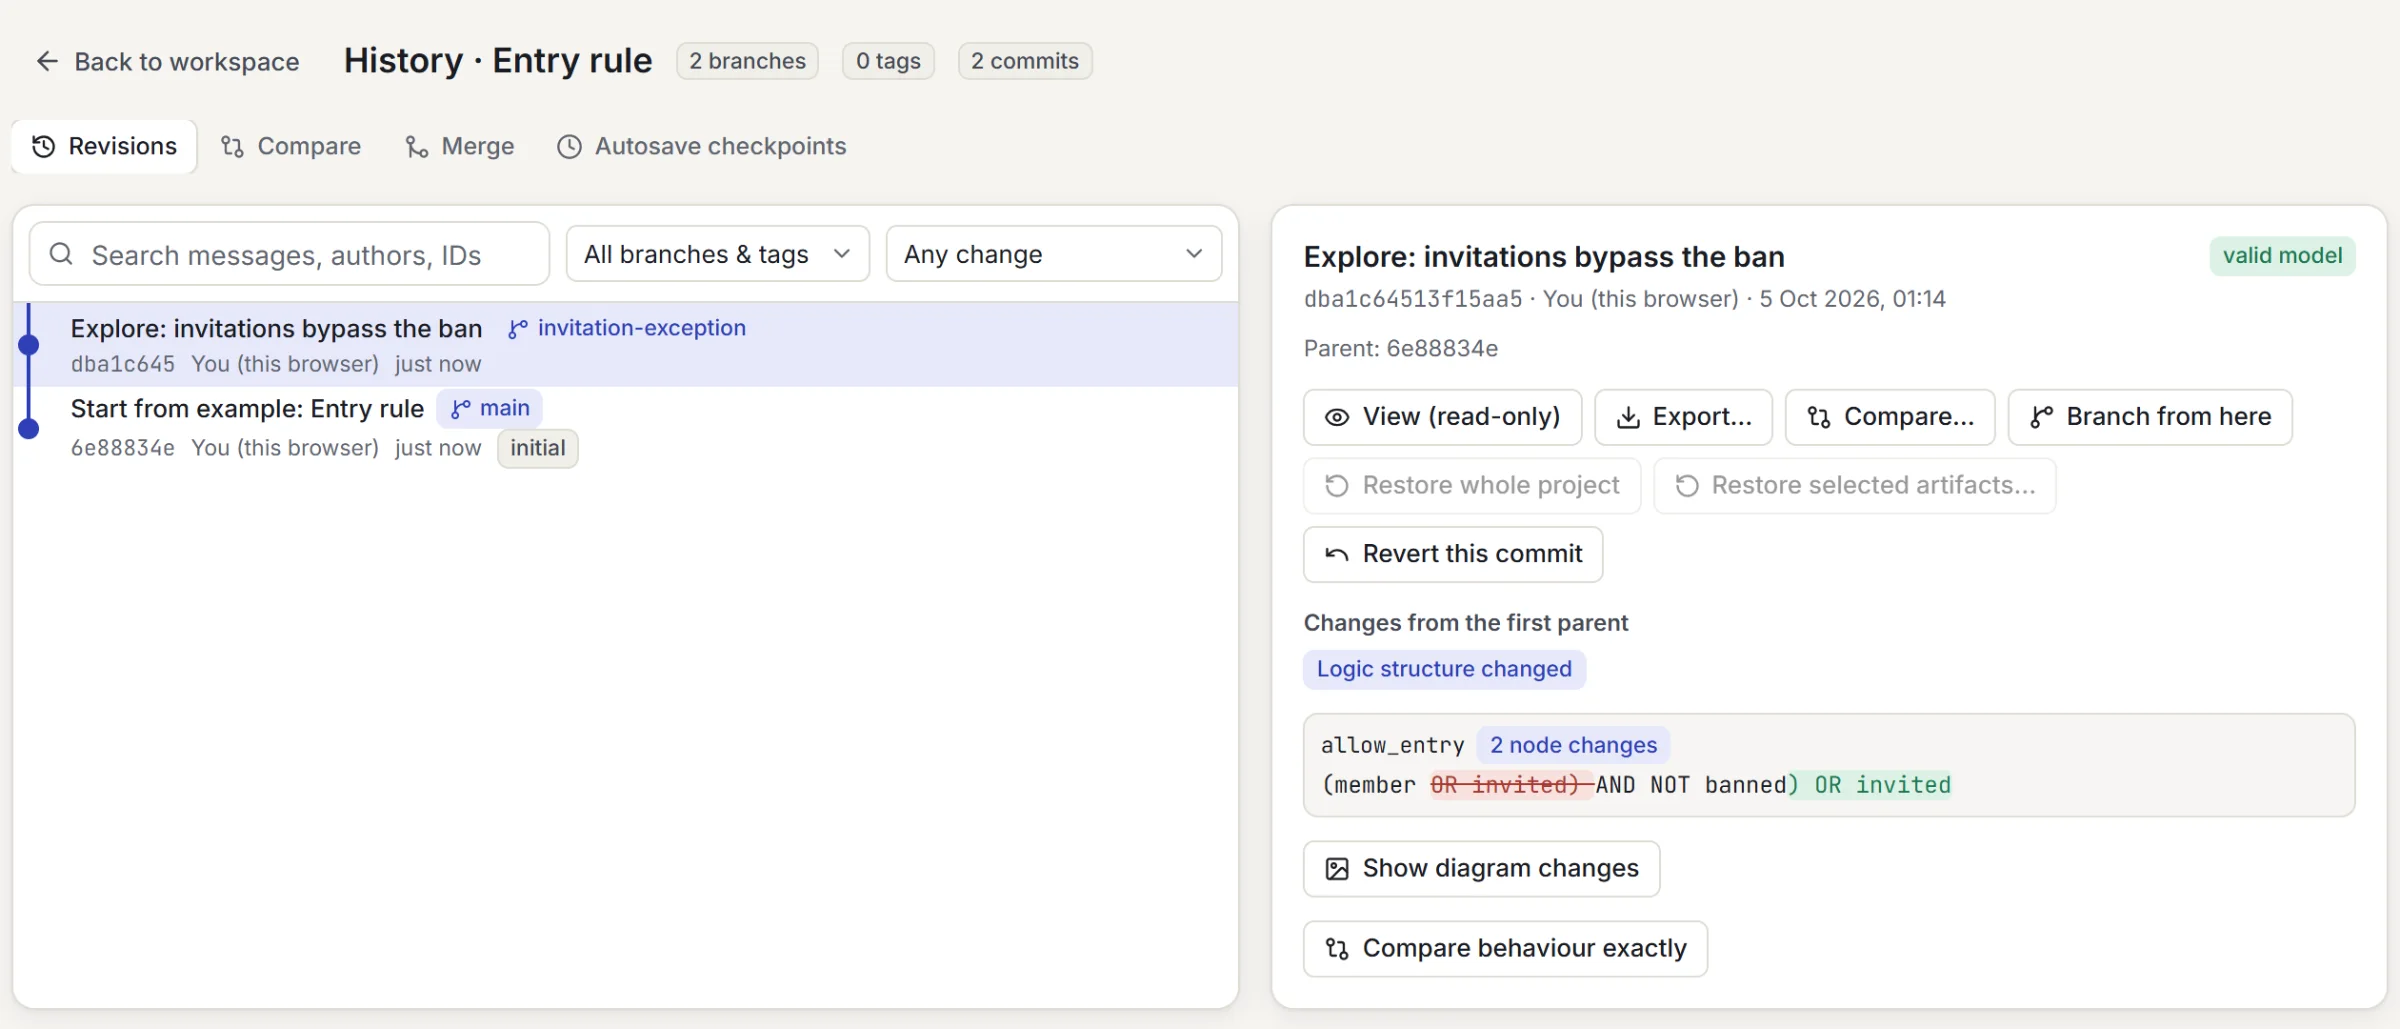
Commits explícitos con mensajes, más puntos de guardado automático recuperables que se conservan 30 días, incluso para borradores inválidos. Convierte cualquier punto de guardado en un commit con nombre.
Crea una rama para explorar una excepción sin tocar el original. Las etiquetas nombran un commit fijo; una etiqueta de base aprobada exige además comprobaciones al día y una interpretación confirmada.
El texto, la estructura, la disposición visual y el comportamiento se comparan por separado. Un cambio de formato, una refactorización equivalente, un cambio de alcance y un cambio de comportamiento reciben cada uno su propia etiqueta.
Las ediciones compatibles se combinan. Las que entran en conflicto, como cambios al mismo operador, conexión, significado, expectativa de prueba o nota, se muestran para su revisión. Las comprobaciones pertinentes se vuelven a ejecutar antes de que confirmes la combinación.
Abre solicitudes de combinación, exige la aprobación de un revisor independiente y protege las ramas importantes con comprobaciones al día obligatorias. Las reglas se aplican en el servidor.
Restaura un proyecto entero o artefactos seleccionados, con las dependencias resueltas primero. Una restauración es siempre un commit nuevo, y los comentarios y las notas posteriores nunca se revierten.
El historial, las ramas y las comparaciones funcionan sin conexión en los proyectos locales. No hace falta una cuenta de Git ni un repositorio externo, y los archivos exportados son deterministas, así que también puedes guardarlos en tu propio repositorio.
Colaborar
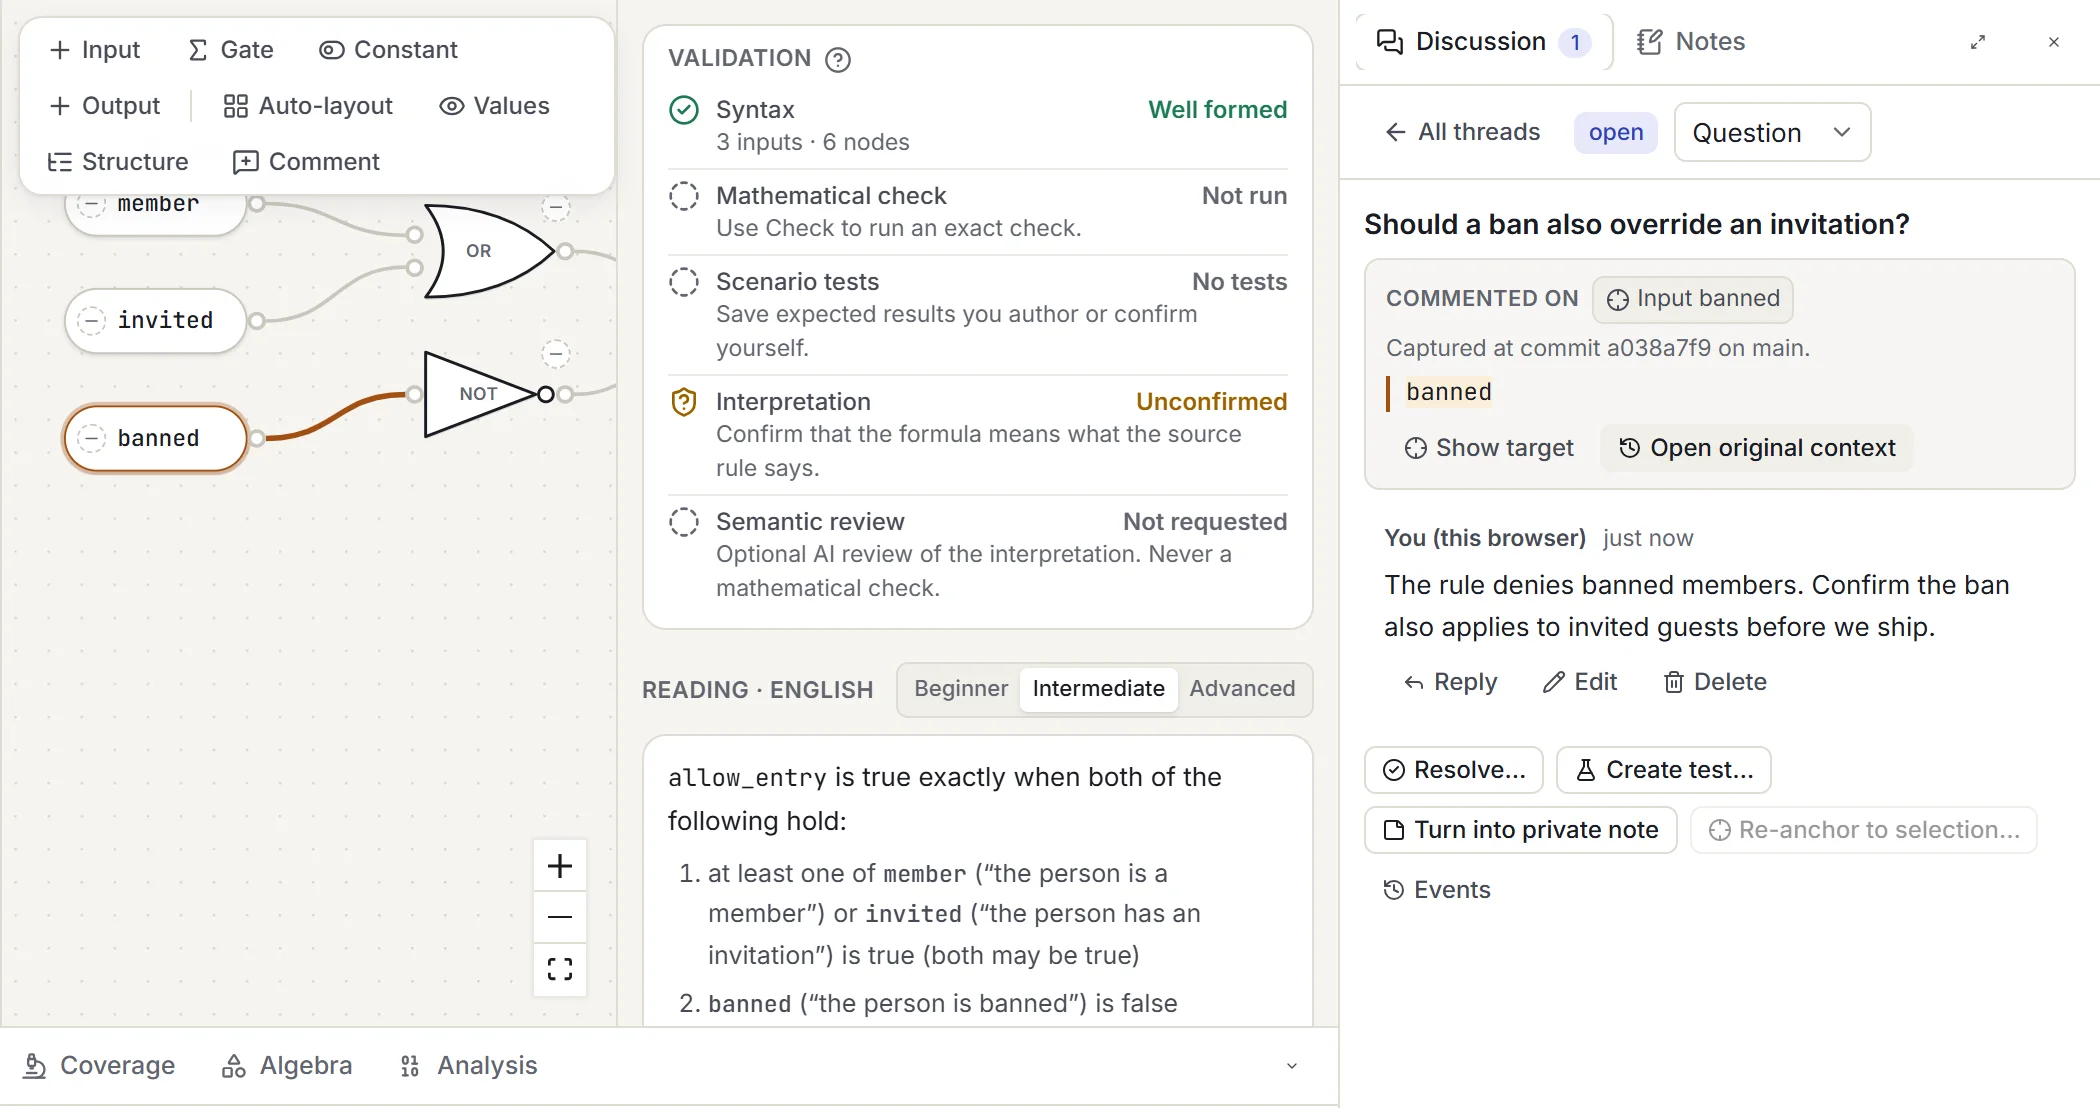
Comenta exactamente sobre lo que quieres decir: un fragmento de fórmula, una compuerta, una cláusula, una prueba o una revisión. Si la lógica cambia después, el comentario lo dice en lugar de adherirse en silencio a algo nuevo.
Inicia sesión y copia un proyecto local a tu nube personal o de equipo. Edita sin conexión y sincroniza después; las ediciones simultáneas se conservan lado a lado para una combinación explícita, nunca se sobrescriben.
Propietario, administrador, editor, comentarista y lector. Los comentaristas pueden discutir pero no editar la lógica; los lectores pueden leer. Las notas privadas siguen siendo privadas, incluso para propietarios y administradores.
Comparte una instantánea fija de solo lectura que nunca sigue las ediciones posteriores. Los enlaces son privados hasta que concedes acceso, y pueden revocarse o configurarse para que caduquen.
Configura la revisión opcional con IA con tus propias preguntas y umbrales, que cubran condiciones omitidas, el alcance de las excepciones o un «solo si» invertido. Versionadas, y nunca un sustituto de la confirmación.
Mantén los términos compartidos, los sinónimos y los supuestos de dominio confirmados en un único glosario versionado. Cambiar un término retira las aprobaciones que dependían de él.
Publica subcircuitos, categorías con sus listas de valores, escalas y correspondencias entre escalas en una biblioteca de equipo. Los modelos se mantienen fijados a la versión que usan hasta que alguien revisa y aprueba la actualización.
Exportar
Exporta un solo artefacto, una selección o todo desde una misma revisión fija, de modo que un paquete nunca pueda mezclar una fórmula antigua con un diagrama más nuevo. Las exportaciones se ejecutan en tu navegador, nunca llaman a la IA y nunca cambian el proyecto.
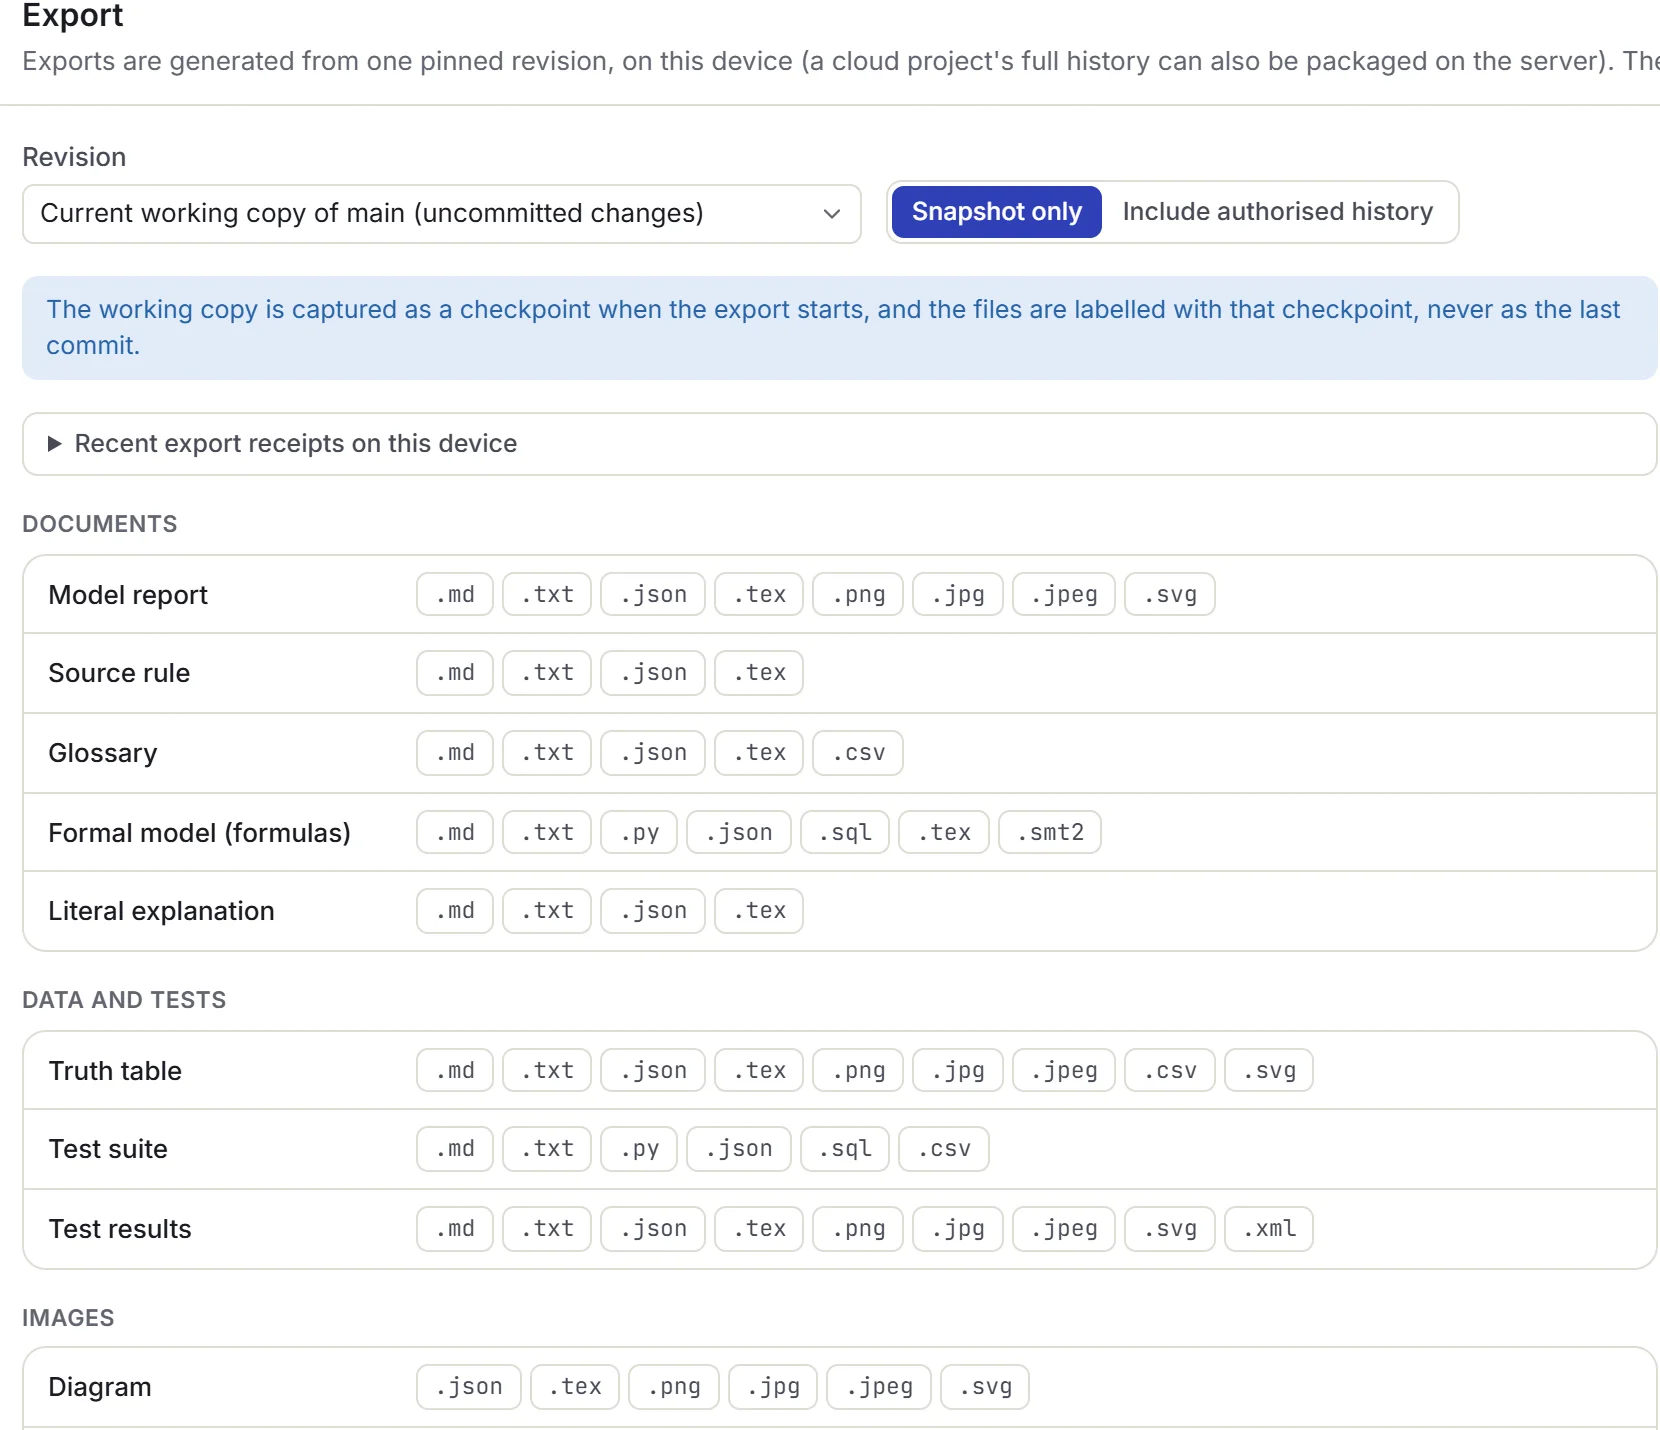
| Formato | Lo que obtienes |
|---|---|
.py | Un evaluador legible en Python 3 y un conjunto de pruebas unittest, con comprobaciones estrictas de entradas booleanas: las cadenas, los números y None se rechazan, nunca se convierten. Los umbrales, los valores de categoría, los niveles de escala, los conteos y los puntos se calculan a partir de los valores que pasas, los valores no declarados se rechazan, y un conjunto de resultados devuelve su etiqueta. |
.sql | Una expresión booleana de PostgreSQL con un SELECT de solo lectura y un arnés de pruebas con VALUES. Las entradas ausentes o NULL se informan como inválidas, nunca se tratan en silencio como FALSO. Los conteos y las puntuaciones son sumas de expresiones CASE, y un conjunto de resultados es un CASE en el orden de la tabla. |
.smt2 | Definiciones booleanas SMT-LIB y consultas de satisfacibilidad con alcance, incluidas completitud, exclusividad, rigor y monotonía, con cada resultado sat / unsat explicado. |
.tex | Fragmentos LaTeX o informes independientes: fórmulas, tablas de verdad, tablas de decisión, pasos de álgebra, y diagramas y mapas de Karnaugh en TikZ, compuertas de conteo y de puntuación incluidas. |
.md · .txt | Informes legibles: reglas originales, explicaciones, glosario, pruebas y resultados, transformaciones, comentarios y notas. |
.json | El formato nativo sin pérdidas: una instantánea del proyecto o un paquete con historial completo que puedes volver a importar. |
.png · .jpg · .jpeg · .svg | Diagramas, páginas de tablas de verdad, mapas y tarjetas de informe, al tamaño, escala y tema que elijas, con datos JPEG reales bajo cualquiera de las dos extensiones. |
.csv · .xml | Tablas de verdad y conjuntos de escenarios en CSV, con la inyección de fórmulas de hoja de cálculo neutralizada; informes de pruebas XML compatibles con JUnit. |
El Python, SQL y SMT-LIB generados se producen a partir de plantillas probadas, nunca con IA, y se contrastan con el motor sobre miles de modelos generados antes de cada versión publicada. Exportar código no lo ejecuta.
Aprender
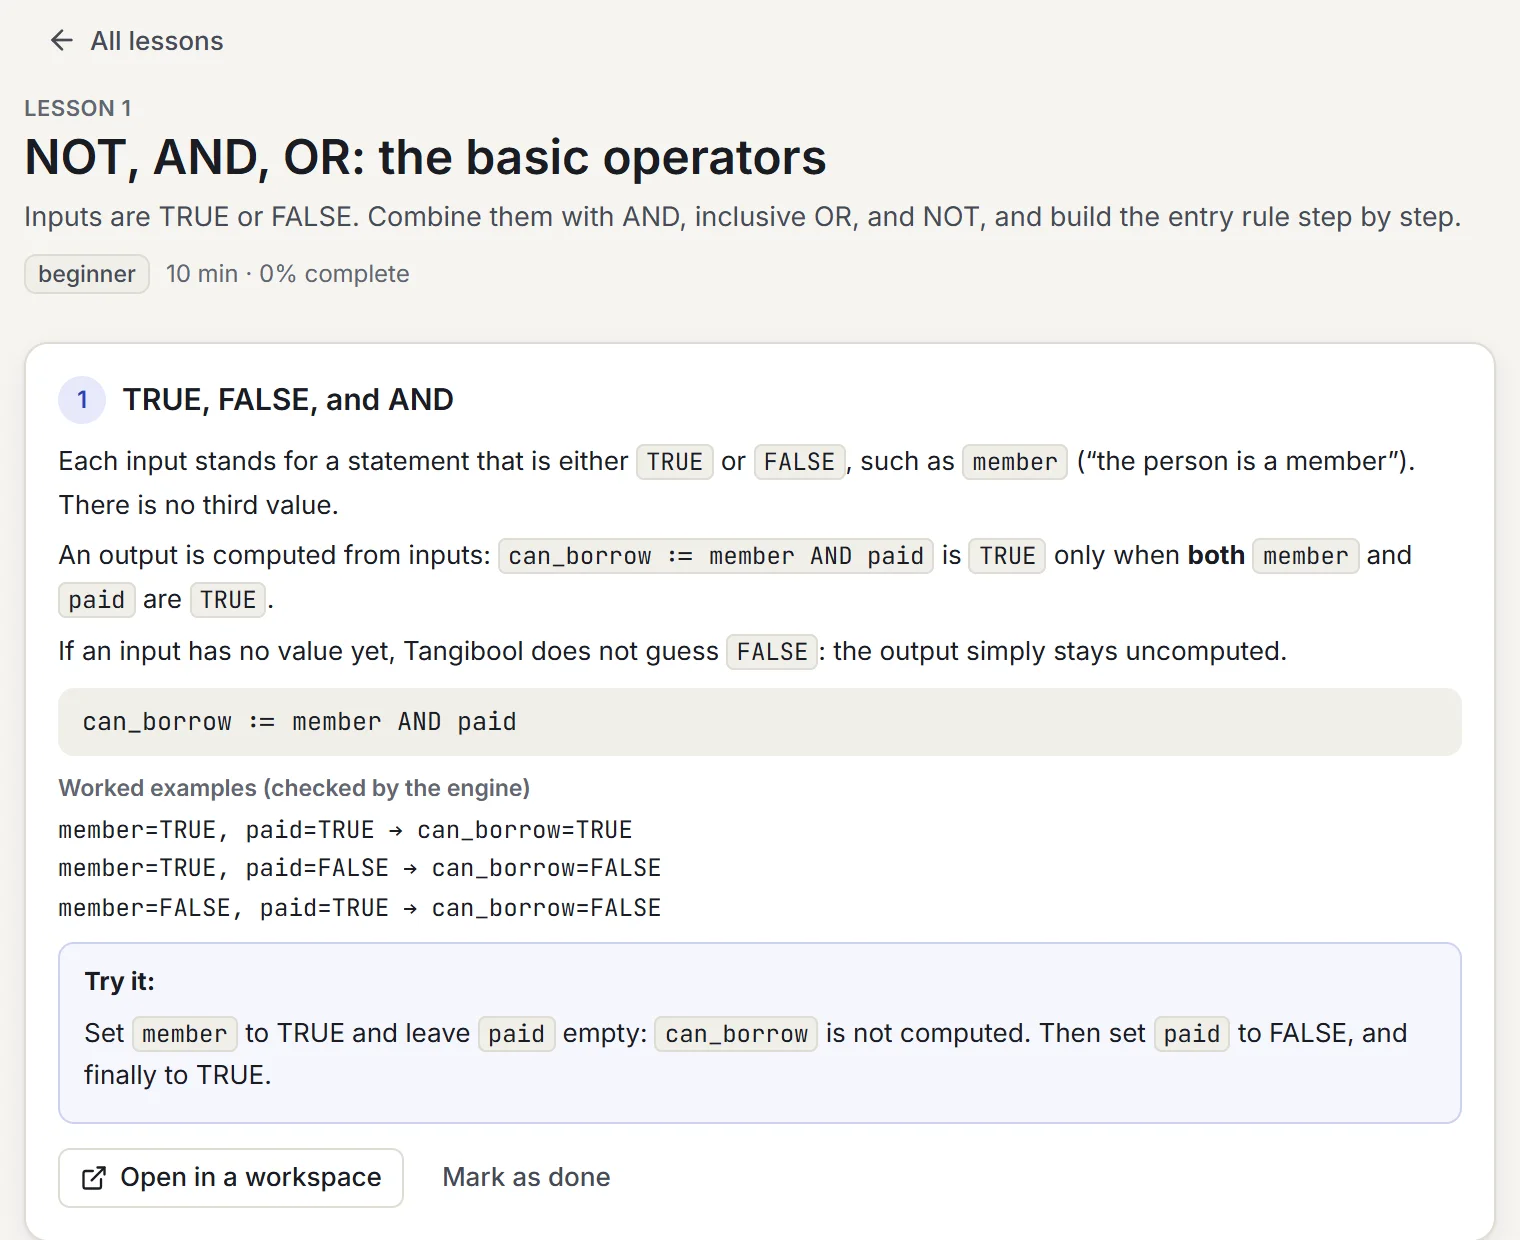
Cada lección abre modelos reales del espacio de trabajo comprobados por el mismo motor, no ilustraciones desconectadas. Los ejercicios dan retroalimentación concreta con escenarios reproducibles, en los cuatro idiomas de contenido. El progreso se guarda en tu dispositivo, y en tu cuenta cuando inicias sesión.
Honesto por diseño
La confianza nace de decir exactamente qué se comprobó, y qué no. Estas reglas están integradas en cada resultado, informe y exportación.
Una comprobación que supera su presupuesto dice «No determinado». Nunca se convierte en una marca verde, y una lista de formas de cumplir o un mapa de rigor que agotó su presupuesto se etiqueta como parcial.
Cambia la lógica, los supuestos o las pruebas y los resultados anteriores dicen a qué revisión pertenecen y no pueden aplicarse.
Un argumento cuyas premisas se contradicen entre sí es «válido» solo de forma vacua, y se te dice de forma destacada.
Los resultados insatisfacibles se etiquetan como «comprobados con solucionador». Tangibool no afirma tener certificados de demostración verificados de forma independiente.
Una simplificación es mejor según el objetivo que elegiste, como menos operadores, y una razón de un resultado es irreducible: no sobra ningún hecho, puede haber otras razones. Ninguna de las dos se llama nunca «la más pequeña posible».
La cobertura estructural y las puntuaciones de mutación miden tus pruebas. Nunca se presentan como prueba de que la regla es correcta.
Ninguna confianza de la IA se muestra jamás como garantía matemática, y ninguna salida de la IA se acepta sin ti.
Tangibool verifica el modelo que le das, no la verdad en el mundo real, la legalidad, la completitud ni la seguridad de una política.
Límites operativos
Estos límites mantienen cada operación rápida y exacta. Se aplican a todos los planes y describen tamaños admitidos, no funciones que tengas que desbloquear. Cualquier cosa que los supere falla con claridad en lugar de devolver un resultado parcial disfrazado de completo.
Tangibool trabaja con lógica booleana de dos valores y lógica proposicional. Los números, las categorías, las escalas, los conteos y las puntuaciones entran mediante entradas definidas fuera de las fórmulas, como age_at_least_18 para age ≥ 18 o plan IN Paid, y se compilan a entradas VERDADERO/FALSO cuyas relaciones se derivan de forma exacta. No hace aritmética más allá de un conteo o un total de puntos, no compara dos cantidades distintas salvo en una misma escala ordenada, no evalúa texto, fechas ni unidades, y no cuantifica sobre colecciones como líneas de pedido o posiciones de una cartera.
| Qué | Límite |
|---|---|
| Entradas distintas por modelo | 64 |
| Salidas escritas · premisas · supuestos por modelo | 64 cada uno |
| Nodos de expresión (tras expandir los subcircuitos) | 500 |
| Profundidad de anidamiento | 64 |
| Categorías por modelo · valores por categoría · listas de valores | 64 · 2,000 · 500 |
| Profundidad de una jerarquía de listas | 16 |
| Escalas ordenadas por modelo · niveles por escala · valores externos | 64 · 100 · 8 |
| Operandos de una restricción de conteo | 2–64 |
| Tablas de puntos por modelo · filas por tabla · puntos por fila | 32 · 64 · −1,000 a 1,000 |
| Conjuntos de resultados por modelo · etiquetas por conjunto | 32 · 32 |
| Tabla de decisión | 500 filas · 64 columnas |
| Pruebas de pertenencia por entrada de conjunto | 12 |
| Tabla de verdad, automática | 8 entradas · 256 filas |
| Tabla de verdad, bajo demanda | 12 entradas · 4,096 filas |
| Mapas de Karnaugh | 0–4 entradas |
| Tamaño de FNC / FND | 4,096 cláusulas · 20,000 literales |
| Ejecución de mutación | 500 mutantes · 30 s |
| Presupuesto del solucionador en el servidor (por defecto) | 2 s por consulta |
| Análisis de por qué un resultado y de rigor | 10 s por operación |
| Formas de cumplir enumeradas | 200 |
| Cambios mínimos | distancia hasta 4 · 50 enumerados |
| Mapa de rigor | 12 reglas |
| Pruebas guardadas por modelo | 1,000 |
| Solicitud de redacción en lenguaje natural | 4,000 caracteres |
| Nota · comentario | 50,000 · 10,000 caracteres |
| Archivo de exportación | 100 MiB · 10,000 archivos |
| Imágenes | 8,192 px por lado · 32 MP |
Preguntas frecuentes
No. Abre la app y empieza a trabajar: los proyectos, el historial, las pruebas, las notas, las lecciones y las exportaciones funcionan sin iniciar sesión, guardados en tu navegador. Inicia sesión cuando quieras sincronización en la nube, equipos, compartir, solicitudes de combinación o redacción con IA. El almacenamiento del navegador no es una copia de seguridad en la nube, así que exporta o copia a la nube los proyectos importantes.
Nunca. La IA puede redactar una fórmula a partir de tus palabras, sugerir aclaraciones, reformular una explicación o revisar un borrador en busca de omisiones probables. Cada resultado matemático proviene del motor determinista, y solo tú puedes confirmar lo que una regla debe decir. Puedes desactivar la IA por completo y conservar todas las funciones deterministas.
Para los modelos más grandes, Tangibool ejecuta una consulta SAT acotada en el servidor, pero solo después de avisarte de que el modelo se enviará. Si la consulta termina, obtienes una respuesta exacta; si se agota el presupuesto, el resultado es «No determinado». Nunca presenta una muestra de escenarios como una comprobación completa.
Sí, mediante entradas de umbral. Una condición como «la edad es al menos 18» se convierte en la entrada age_at_least_18, definida como age ≥ 18 sobre la cantidad age. La fórmula sigue usando una entrada VERDADERO/FALSO, un escenario o una prueba guardada puede dar el número en sí, que decide cada umbral sobre esa cantidad por comparación exacta, y el orden entre umbrales se deriva por ti: quien tiene 25 años o más tiene 21 o más. El mismo patrón cubre los valores de categoría (plan IN Paid), los niveles de una escala ordenada (rating ≥ BBB-), los conteos de condiciones y los totales de puntos. Tangibool no hace ninguna otra aritmética, y nunca infiere que «socio premium» implica «socio» a menos que añadas ese supuesto.
Sí. Un conjunto de resultados nombra sus resultados en orden, como Aprobar, Derivar y Rechazar, y los define como una condición por resultado, como una lista de reglas en la que gana la primera que coincide, o como una tabla de decisión con la política de coincidencia Única, Cualquiera, Primera o Prioridad. Cada resultado se compila a una salida booleana, así que todas las comprobaciones exactas siguen aplicándose, y el motor comprueba que cada caso admisible recibe exactamente un resultado, informando de las lagunas, las superposiciones y las filas que nunca pueden aplicarse con un caso reproducido para cada una.
Sí. Pon ambas reglas en un mismo modelo, o compara dos revisiones o dos ramas, y pregunta si una es al menos tan estricta como la otra: cada caso que permite la regla más estricta lo permite también la menos estricta. La respuesta es equivalente, al menos tan estricta, menos estricta o incomparables, con un caso reproducido por cada dirección que falla. Un mapa de rigor ordena hasta doce reglas a la vez, las capas de reglas como regulación, folleto, mandato y límite interno se comprueban en orden, y las mismas comprobaciones se ejecutan como pruebas de propiedad en integración continua.
Sí. Exporta el proyecto como paquete JSON nativo y ejecútalo con el ejecutor sin interfaz tangibool, que usa el mismo motor que el navegador. Escribe informes JSON y compatibles con JUnit, y sale con 0 solo cuando se ejecutó al menos una prueba aplicable y todas pasaron, con 1 cuando falló una aserción y con 2 ante una entrada inválida o no concluyente.
Para tus reglas, no lo necesita: los commits, las ramas, las etiquetas, las diferencias, las combinaciones y las restauraciones están integrados y entienden la lógica, los diagramas y las pruebas. Como las exportaciones son deterministas, puedes seguir guardando los archivos generados en tu propio repositorio Git si quieres.
Está diseñado según el estándar WCAG 2.2 AA. Cada acción del diagrama tiene una alternativa de teclado, una vista estructurada acompaña al lienzo, los controles están etiquetados para lectores de pantalla, y los valores de verdad siempre usan un icono y una palabra, nunca solo el color. Los análisis automáticos de accesibilidad WCAG 2.2 de las páginas y los diálogos principales forman parte del conjunto de pruebas, tanto en tema claro como en tema oscuro.
Las versiones actuales de Chrome, Edge, Firefox y Safari. Tangibool está pensado primero para escritorio, y en tabletas y teléfonos las mismas funciones se organizan en pestañas en lugar de apretarse en una sola pantalla.
Pega una condición de tu código o una frase de una política, y descubre exactamente lo que hace.